
介紹 ES2024 Object.groupBy() 如何將 iterable 分組成前端可用的結構,並釐清它與 Map.groupBy() 的 key 語意差異。
前置知識:理解 Object property key、iterable 與基本資料轉換。
學習路線:可以先理解物件是什麼,再用新學到的 API 把資料模型落到常見的分組 UI。
標籤:ES2024 Object.groupBy Map.groupBy Data Transformation
Object.groupBy() 取代自己用 reduce() 寫的分組,並知道它只負責「分好組」,加總、排序要另外做array.groupBy():這個名字會弄壞還在用舊套件的網站hasOwnProperty、改群組裡的資料會改到原始資料Map.groupBy():分組依據是物件而不是字串時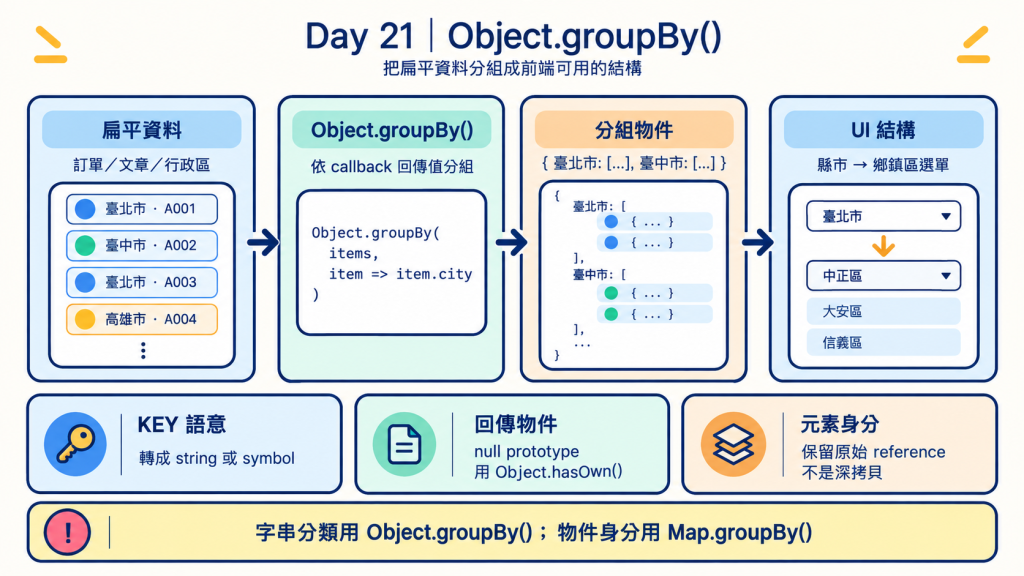
前端很常收到一維的 API 資料,但畫面需要的是「先分類、再顯示」的結構。
例如訂單要按狀態分區、文章要按分類顯示,或是階層式下拉選單要把鄉鎮區放進各自的縣市。以前這類需求常從 reduce() 開始;ES2024 的 Object.groupBy() 則把「依條件分組」變成一個直接的標準 API。
這篇先看它的規則與邊界,最後再把扁平城市資料組成下拉選單可用的結構。
reduce() 建立以前前端常常遇到一種情況是有一批資料,但需要依據某些條件將資料分組,例如有一訂單要依 status 分組:
const orders = [
  { id: "A1", status: "pending", total: 890 },
  { id: "A2", status: "paid", total: 1200 },
  { id: "A3", status: "pending", total: 450 },
];
過去常見寫法是:每次走到一筆資料,先找到它的分組 key;若該群組還不存在,就建立一個陣列,再把資料 push 進去,常常會想到用 reduce 來處理。
const ordersByStatus = orders.reduce((groups, order) => {
  const key = order.status;

  (groups[key] ??= []).push(order);

  return groups;
}, {});

console.log(ordersByStatus);
// {
//   pending: [
//     { id: "A1", status: "pending", total: 890 },
//     { id: "A3", status: "pending", total: 450 },
//   ],
//   paid: [{ id: "A2", status: "paid", total: 1200 }],
// }
這沒有錯;reduce() 是通用的累積工具。
但這段真正想表達的事情其實很單純:把每筆資料依
status分組。
Object.groupBy():把「怎麼分組」寫出來最近 ECMA 2024 推出的 Object.groupBy 可以讓這個需求更明確簡單:
const ordersByStatus = Object.groupBy(
  orders,
  (order) => order.status,
);
第一個參數是資料來源,第二個參數是「這一筆資料要歸到哪一組」的 callback。
Object.groupBy(items, (item, index) => groupKey)
上面的訂單範例,callback 對每筆訂單回傳 order.status,所以輸出會依 pending、paid 建立群組:
console.log(ordersByStatus.pending);
// [
//   { id: "A1", status: "pending", total: 890 },
//   { id: "A3", status: "pending", total: 450 },
// ]
Object.groupBy() 不做加總、不排序,也不替資料改形狀;它只完成一件事:把每個元素放進 callback 指定的群組陣列。
若分組後要算各狀態的金額,可以在結果上繼續處理。要注意的是:回傳的外層是物件,沒有 map() 這類 Array methods;但每個群組本身已經是陣列。
因此要逐組處理時,先用
Object.entries()轉成[status, group]陣列,算完再用Object.fromEntries()組回物件:
const totalByStatus = Object.fromEntries(
  Object.entries(ordersByStatus).map(([status, group]) => [
    status,
    group.reduce((total, order) => total + order.total, 0),
  ]),
);

console.log(totalByStatus);
// { pending: 1340, paid: 1200 }
Array.prototype.groupBy()?第一次看到這個 API 時,我的直覺是它應該能直接用在陣列上;但規格卻把它放在 Object 上,這點一開始讓我有些疑惑:
orders.groupBy((order) => order.status);
提案早期確實想過把它做成 Array.prototype.groupBy()。但 JavaScript 標準不能只考慮「新 API 好不好用」,還得確認它會不會讓已上線的舊網站改變行為。
當時有舊版 Sugar.js 會在 Array.prototype 加上自己定義的 groupBy。這類套件通常會先檢查方法是否存在:
if (!Array.prototype.groupBy) {
  Array.prototype.groupBy = function (callback) {
    // Sugar 自己的分組實作
  };
}
一旦瀏覽器加入同名的原生方法,Sugar 就不會再覆蓋它。舊網站原本呼叫的 items.groupBy(),便可能從 Sugar 的行為悄悄變成瀏覽器的原生行為;即使名稱相同,參數或回傳值的細節不同,功能就可能壞掉。
TC39 找到約 660 個仍使用這類舊 Sugar 版本的網站來源。這不代表 Sugar 是現在下載量最高的套件;但對一個幾乎無法收回的瀏覽器標準來說,已知會破壞既有網站就足以避開。提案也曾嘗試 Array.prototype.group,但同樣撞到既有網站把 Array 當成任意 hash map 使用的情況。
因此最後選擇不掛在 Array prototype,而是採用靜態方法:
Object.groupBy(items, callback);
Map.groupBy(items, callback);
這裡的 Object 是在說「分組結果採 Object property model」,不是說輸入必須是普通 Object。
Object.groupBy() 參數可以接受的是 iterable,不是只接受 Array。
因此只要資料來源能被 for...of 逐筆讀取,就能分組。例如 Set:
const tags = new Set(["javascript", "css", "java", "html"]);

const tagsByFirstLetter = Object.groupBy(
  tags,
  (tag) => tag[0],
);

console.log(tagsByFirstLetter);
// {
//   j: ["javascript", "java"],
//   c: ["css"],
//   h: ["html"],
// }
Array 當然是最常見的來源;這個規則的重點是,API 關心的是「你能否逐筆提供元素」,而不是它是不是 Array。
Object.groupBy() 的輸出是 Object,所以 callback 回傳的分組依據,最後必須能成為 Object 的 property key:string 或 symbol。
數字看起來像數字,但輸出時會轉成字串 property name:
const numbersByParity = Object.groupBy(
  [1, 2, 3, 4],
  (number) => number % 2,
);

console.log(numbersByParity);
// { "0": [2, 4], "1": [1, 3] }

Object.keys(numbersByParity);
// ["0", "1"]
這和 Object property model 是同一件事:Object 的 key 最終是 string 或 symbol。
{},而是 null-prototype object還有另一個比較容易被忽略的小細節:
Object.groupBy() 回傳的不是一般物件,而是 沒有 prototype 的 object,像昨天提到過物件有所有所謂的繼承特性。
const grouped = Object.groupBy([1, 2, 3], (number) => number % 2);

Object.getPrototypeOf(grouped) === null;
// true
因此它不繼承 Object.prototype,像 hasOwnProperty 這種方法不會存在:
grouped.hasOwnProperty;
// undefined

Object.hasOwn(grouped, "0");
// true
白話說:一般物件會從 Object.prototype 繼承 toString、hasOwnProperty 這些方法;這個物件什麼都沒繼承,身上只有分好的群組。
| 寫法 | 能不能用 | 原因 |
|---|---|---|
grouped.hasOwnProperty()、grouped.toString() |
❌ | 這些方法來自 Object.prototype,它沒有繼承 |
`${grouped}`、grouped + "" |
❌ 拋出 TypeError | 轉成字串需要 toString |
Object.keys()、Object.entries()、Object.hasOwn() |
✅ | 靜態方法,是把物件當參數傳進去,不靠繼承 |
JSON.stringify()、console.log()、for...in |
✅ | 只讀物件自己身上的屬性 |
要確認某個群組是否存在,用 Object.hasOwn(grouped, "0") 最清楚。
群組名稱來自資料,你無法保證資料裡不會出現 "toString" 這種字。
問題在於:一般 {} 讀取自己沒有的屬性時,會往 prototype 上找。所以即使還沒建立某個群組,讀這個名稱也不一定是 undefined:
| 名稱 | 一般 {} 讀到 |
沒有 prototype 的物件讀到 |
|---|---|---|
"normal" |
undefined |
undefined |
"toString" |
繼承來的函式 | undefined |
"hasOwnProperty" |
繼承來的函式 | undefined |
"constructor" |
Object 建構函式 |
undefined |
"__proto__" |
Object.prototype 本身;寫入時還會換掉物件的 prototype,群組根本建不起來 |
undefined |
這不是說有人會故意拿這些名稱來分類,而是資料剛好出現這些字。例如技術部落格依標籤分組文章,JavaScript 文章的標籤就很可能是 constructor 或 toString:
const posts = [
  { title: "class 語法入門", tag: "constructor" },
  { title: "物件轉字串的規則", tag: "toString" },
  { title: "把資料分組", tag: "groupBy" },
];
用第一節的 reduce() 寫法分組,第一篇文章就會讓程式壞掉:
posts.reduce((groups, post) => {
  (groups[post.tag] ??= []).push(post);
  return groups;
}, {});
// TypeError: groups[post.tag].push is not a function
原因是 groups.constructor 讀到的是繼承來的 Object 建構函式,不是 undefined,所以 ??= 以為這個群組已經存在,不會建立新陣列;接著對函式呼叫 push,就拋錯了。
同一批資料交給 Object.groupBy(),因為回傳的物件沒有 prototype,constructor、toString 就只是普通的標籤名稱:
const postsByTag = Object.groupBy(posts, (post) => post.tag);

postsByTag.constructor;
// [{ title: "class 語法入門", tag: "constructor" }]

postsByTag.toString;
// [{ title: "物件轉字串的規則", tag: "toString" }]
ES2024 規格在三個步驟上避開撞名:
| 規格步驟 | 白話 |
|---|---|
GroupBy 用內部清單暫存群組 |
分組時先記在規格內部的清單,不透過物件讀寫,所以不會讀到繼承來的東西 |
OrdinaryObjectCreate(null) |
建立一個沒有 prototype 的物件來裝結果 |
CreateDataPropertyOrThrow |
把群組直接放到物件上,不會觸發 __proto__ 的特殊行為 |
規格的說明也直接寫明,回傳值是 「does not inherit from %Object.prototype%」的物件。換句話說,它就是一張單純的「群組名稱 → 陣列」對照表,不是一般用途的物件。
突然覺得在開發這些新語法時,其實也要考量會不會有使用者真的無聊這樣用,導致程式碼崩潰😂
群組陣列裡放的是原本元素的 reference,不是深拷貝。
const products = [
  { name: "鍵盤", category: "peripheral", stock: 3 },
  { name: "螢幕", category: "display", stock: 5 },
];

const productsByCategory = Object.groupBy(
  products,
  (product) => product.category,
);

productsByCategory.peripheral[0].stock = 0;

console.log(products[0].stock);
// 0
這通常很合理:分組只是替同一批資料建立不同檢視方式,不應默默產生另一份資料副本。若 UI state 需要不可變更新,仍應在自己的 state 更新流程中建立新物件。
剛成為前端工程師時,我遇過一個需求:客戶分成很多種類型,每種類型有不同的消費屬性標籤,而每一層標籤的分類,又依附在上一層的條件上。
當時我很直覺地想:那就用巢狀物件一層層疊下去吧。
// 當時的寫法:分類層級直接寫死在資料結構裡
const customers = {
  enterprise: {
    highSpending: {
      repeatBuyer: [/* 客戶 */],
      seasonal: [/* 客戶 */],
    },
  },
  individual: {
    // ...
  },
};
一開始確實能用,但缺點很快就浮現:層級被寫死在資料結構裡。之後商業需求一變,例如中間多一層「地區」,或改成先看消費屬性、再看客戶類型,整個巢狀結構都得重建,所有 customers[type][spending][habit] 這類讀取的程式也要跟著改。
比較好的做法是反過來:資料本身保持扁平,每筆資料帶著自己的分類欄位;畫面需要階層時,再依當下的需求分組組出來。
const customers = [
  { name: "A 公司", type: "enterprise", spending: "high", habit: "repeatBuyer" },
  { name: "王小明", type: "individual", spending: "normal", habit: "seasonal" },
];
這樣分層順序改了,只要改分組條件,不必動原始資料。本節最後的 buildHierarchy() 就是這個做法:呼叫端只要決定欄位順序。
地址資料也是同樣的形狀:縣市 → 鄉鎮區,每一層都依附在上一層。下面就用它當例子。
假設 API 回傳的是扁平的行政區資料:
const districts = [
  { id: "taipei-zhongshan", city: "臺北市", name: "中山區", zipCode: "104" },
  { id: "taipei-da-an", city: "臺北市", name: "大安區", zipCode: "106" },
  { id: "taichung-xitun", city: "臺中市", name: "西屯區", zipCode: "407" },
];
畫面上的「選擇行政區」元件,可能想要的是依縣市分組的選項:
[
  {
    label: "臺北市",
    options: [
      { label: "中山區(104)", value: "taipei-zhongshan" },
      { label: "大安區(106)", value: "taipei-da-an" },
    ],
  },
  {
    label: "臺中市",
    options: [{ label: "西屯區(407)", value: "taichung-xitun" }],
  },
]
先交給 Object.groupBy() 依縣市分組:
const districtsByCity = Object.groupBy(
  districts,
  (district) => district.city,
);
再把分組結果轉成元件需要的 shape:
const districtOptions = Object.entries(districtsByCity).map(
  ([city, cityDistricts]) => ({
    label: city,
    options: cityDistricts.map((district) => ({
      label: `${district.name}(${district.zipCode})`,
      value: district.id,
    })),
  }),
);
這裡可以把責任拆得很清楚:
Object.groupBy()
→ 回答「每個鄉鎮區屬於哪個縣市?」

Object.entries() + map()
→ 回答「地址選單元件要吃什麼資料結構?」
Object.groupBy() 不是直接替你建出完整地址 tree,也不是 UI 元件專用 API;它只是先把扁平資料按照一個字串分類。後續的 builder 再依 UI 元件的需求,組出 label、options 等欄位。
實際表單通常會把資料拆成兩個控制項:第一個 select 顯示縣市;使用者選定縣市後,第二個 select 再讀取 districtsByCity[selectedCity] 顯示該縣市的鄉鎮區。路、街、巷、弄、號則屬於自由輸入欄位,不需要硬塞進分組結果。
若資料還有更深的固定層級,例如「縣市 → 鄉鎮區 → 郵遞區號」,可以在每組結果上再做一次 Object.groupBy()。
以下用含有 city、district 與 zipCode 的地址資料示範:
const addresses = [
  { city: "臺北市", district: "大安區", zipCode: "106" },
  { city: "臺北市", district: "信義區", zipCode: "110" },
  { city: "臺中市", district: "西屯區", zipCode: "407" },
];
const byCity = Object.groupBy(addresses, (address) => address.city);

const hierarchy = Object.fromEntries(
  Object.entries(byCity).map(([city, items]) => [
    city,
    Object.groupBy(items, (address) => address.district),
  ]),
);
這就是「先依 city 分組,再讓每個城市底下依 district 分組」。因此可以用巢狀 key 讀取最底層資料:
hierarchy["臺北市"]["大安區"];
// [{ city: "臺北市", district: "大安區", zipCode: "106" }]
若分層欄位不只兩三個,或希望同一套邏輯可重複使用,可以把逐層分組封裝成資料階層 builder:
function buildHierarchy(items, keys, fallback = "未分類") {
  if (keys.length === 0) return items;

  const [currentKey, ...restKeys] = keys;

  const grouped = Object.groupBy(
    items,
    (item) => item[currentKey] ?? fallback,
  );

  if (restKeys.length === 0) {
    return grouped;
  }

  return Object.fromEntries(
    Object.entries(grouped).map(([key, group]) => [
      key,
      buildHierarchy(group, restKeys, fallback),
    ]),
  );
}

const addressHierarchy = buildHierarchy(
  addresses,
  ["city", "district"],
);
它的規則很單純:先拿第一個 key 做一層分組;後面還有 key 時,就對每一組遞迴呼叫自己。呼叫端只要決定欄位順序:
buildHierarchy(addresses, ["city", "district"]);
buildHierarchy(addresses, ["city", "district", "zipCode"]);
注意 if (keys.length === 0) return items 不能省略。若少了這個判斷,傳入空陣列時 currentKey 會是 undefined,item[undefined] 讀不到值,資料會全部落進 fallback 群組,多出一層沒有意義的分類。
真實 API 資料不一定完整。若某筆資料沒有 district,直接回傳 item[currentKey] 時,Object.groupBy() 會把 undefined 轉成字串 "undefined" 作為群組名稱。
上面的 buildHierarchy() 使用 ?? fallback,會把它明確放進 "未分類":
const addressesWithGaps = [
  ...addresses,
  { city: "高雄市", district: undefined, zipCode: "800" },
];

const hierarchyWithFallback = buildHierarchy(
  addressesWithGaps,
  ["city", "district"],
);

Object.keys(hierarchyWithFallback["高雄市"]);
// ["未分類"]
這代表「保留資料,但明確標示資料不完整」。若缺值資料本來就不該進入地址選單,則在建構前先過濾:
const cleanedAddresses = addressesWithGaps.filter(
  (address) => address.city && address.district,
);

const cleanedHierarchy = buildHierarchy(
  cleanedAddresses,
  ["city", "district"],
);
fallback
→ 保留資料,顯示「未分類」供後續檢查

filter
→ 不把不完整資料交給選單
不論選哪一種,重點都是不要讓隱式轉型得到的 "undefined" 靜悄悄成為正常群組名稱。
Object.groupBy() 接受 iterable、將 callback 結果轉成 Object property key,並回傳一個 null-prototype object。理解這些規則後,就能安心把它用在 API 資料整理與 UI builder 上。
但若分類 key 是 object、function,或你需要保留任意 JavaScript value 的身分,Object 的 property model 就不再適合。因為物件會被轉成 property key,不同物件可能都變成同一個 "[object Object]" 群組。
這時改用同為 ES2024 的 Map.groupBy() 即可:
const frontend = { name: "frontend" };
const backend = { name: "backend" };

const members = [
  { name: "Amy", team: frontend },
  { name: "Ben", team: backend },
];

const membersByTeam = Map.groupBy(
  members,
  (member) => member.team,
);

console.log(membersByTeam.get(frontend));
// [{ name: "Amy", team: frontend }]
可以用一句話選擇:
分類名稱是字串(狀態、縣市、文章分類)
→ Object.groupBy()
分類 key 是物件本身,必須保留 reference identity
→ Map.groupBy()
Map.groupBy() 是同一個分組概念在 Map 資料模型下的對應工具;理解這個差異即可,不必把它當成另一套全新的分組流程。


 iThome鐵人賽
 看影片追技術